Nenormalno zaznavanje v videu z velikimi podatki z izboljšanim samodejnim kodirnikom
Jul 12, 2023
1. Uvod
Kot naloga računalniškega vida na visoki ravni se zaznavanje video anomalij nanaša na samodejno zaznavanje nenormalnih dogodkov v danem video zaporedju, ki lahko učinkovito loči nenormalne in normalne dejavnosti ter nenormalne kategorije v videu. V zadnjih nekaj letih so raziskovalci izvedli številne raziskave v zvezi z odkrivanjem anomalij [1–9]. V primerjavi z običajnimi dogodki se dogodki, ki se zgodijo redko ali imajo majhno verjetnost, običajno štejejo za nenormalne. Vendar pa je v praksi težko vzpostaviti učinkovit model odkrivanja anomalij zaradi neznanih vrst dogodkov in nejasnih definicij anomalij. Večina obstoječih metod odkrivanja nepravilnosti je zasnovana na podlagi predpostavke, da se vsak vzorec, ki se razlikuje od naučenega normalnega vzorca, obravnava kot nepravilnost. Na podlagi takih predpostavk je lahko ista dejavnost v različnih scenarijih predstavljena kot običajni ali neobičajni dogodki. Na primer, prizor boja, kjer se dve osebi pretepata na ulici, se lahko šteje za nenormalno, medtem ko sta osebi normalni, ko boksata. Poleg tega je v visokodimenzionalnih video podatkih velika količina redundantnih vizualnih informacij, kar poveča težavnost predstavitve dogodkov v video zaporedju.

kitajsko zelišče cistanche
Glede na prejšnja dela lahko metode odkrivanja anomalij na splošno razdelimo na dve vrsti. Nekatere metode odkrivanja anomalij so zasnovane na podlagi napak pri rekonstrukciji, ki se osredotočajo na modeliranje normalnih vzorcev v video sekvencah [3–5, 7, 8, 10, 11]. (te metode se naučijo modela predstavitve značilnosti normalnega vzorca v fazi usposabljanja in uporabijo razlike med nenormalnimi in normalnimi vzorci za določitev končnega nenormalnega rezultata testnih podatkov med fazo testiranja, kot so napake pri rekonstrukciji ali specifični pragovi [7] –14]. Čeprav so metode za odkrivanje anomalij, ki temeljijo na rekonstrukciji, dobre pri rekonstrukciji normalnih vzorcev v video sekvencah, je ključna težava teh metod ta, da se močno zanašajo na podatke o usposabljanju. Druga vrsta metode obravnava odkrivanje anomalij kot problem klasifikacije [ 15, 16]. Za te metode se rezultat anomalije video zaporedja napove z uporabo usposobljenega klasifikatorja za ekstrahiranje značilnosti, kot je histogram optičnega kolega (HOF) ali dinamična tekstura (DT). (Učinkovitost teh metod je močno odvisen od učnih vzorcev.Za doseganje zadovoljive učinkovitosti je ekstrahiranje učinkovitih in diskriminativnih značilnosti bistvenega pomena za takšne metode odkrivanja anomalij [17–20]. Vendar ti dve vrsti metod običajno modelirata razmerja med dogodki na relativno preprost način [7, 10, 21–23]. Upošteva se na primer samo linearni odnos, kar pa ni dovolj za zapletene, zelo nelinearne odnose v mnogih primerih iz resničnega sveta.
Puščavska živa cistanča
V zadnjih letih so bile metode, ki temeljijo na globokem učenju, uporabljene na področju video detekcije in dosegle velik napredek [24–26]. Na primer, samodejni kodirniki (AE) uporabljajo napake pri rekonstrukciji za odkrivanje anomalij, na tej osnovi pa je bila izboljšana vrsta metod. Poleg tega so bila za rešitev problema zaznavanja anomalij uporabljena tudi generativna kontradiktorna omrežja (GAN) in dolgi kratkoročni spomin (LSTM). Vendar pa ima AE lahko močno sposobnost posploševanja, kar ima za posledico sposobnost rekonstruiranja nenormalnih dogodkov. V [14] so raziskovalci poudarili, da bi morala biti rekonstrukcija nenormalnih vzorcev nepredvidljiva, ker ni neobičajnih vadbenih vzorcev, kar lahko vodi do večjih napak pri rekonstrukciji nenormalnih vzorcev. Če imajo nekatere anomalije skupni vzorec sestave z običajnimi podatki o usposabljanju ali če je dekoder "premočan" in ne more dobro dekodirati kod nekaterih anomalij, lahko AE dobro rekonstruira anomalijo. Za premagovanje pomanjkljivosti AE ta članek uporablja pomnilniški modul za izboljšanje globoke AE in razvija metodo AE s povečanim pomnilnikom (Memory AE). Ko je vnesen nov testni vzorec, ga Memory AE ne bo neposredno kodiral in vnesel v dekoder, ampak ga bo uporabil kot poizvedbo za pridobitev ustrezne vsebine v pomnilniškem modulu. (en, vsebina je združena in posredovana v dekoder. (je proces realiziran z naslavljanjem pozornosti. Poleg tega ta članek uporablja razločljive operatorje krčenja, da inducira redkost uteži naslavljanja pomnilnika, kar lahko spodbudi vsebino pomnilnika, da se približa poizvedbam v funkciji prostora. Med fazo usposabljanja kodirnik in dekoder hkrati posodobita pomnilniški modul, da dosežeta nižjo povprečno napako rekonstrukcije. V fazi preizkusa je naučena vsebina pomnilnika določena in uporabljena bo majhna količina običajnih pomnilniških elementov za rekonstrukcijo. Če so ti izbrani kot soseska vhodne kode, bo napaka pri rekonstrukciji zelo očitna. Poskusi na več javnih primerjalnih nizih podatkov kažejo, da je zmogljivost zaznavanja Memory AE dosegla najsodobnejšo raven.

Glavne kemične sestavine Cistanche deserticola
2. Načelo algoritma
Slika 1 prikazuje celotno omrežno strukturo pomnilnika AE, ki je razdeljen na tri podstrukture: kodirnik (uporablja se za kodiranje vnosa in generiranje poizvedb), dekoder (uporablja se za rekonstrukcijo) in pomnilniški modul (s pomnilnikom in povezanimi operacijami naslavljanja). Kot je prikazano na sliki 1, glede na dogodek, ki ga je treba testirati, kodirnik najprej pridobi svojo kodirano vrednost. Z uporabo kodirane vrednosti kot poizvedbe pomnilniški modul pridobi najpomembnejšo vsebino v pomnilniškem modulu prek operaterja naslavljanja na podlagi pozornosti in jo nato posreduje dekoderju za rekonstrukcijo. Med usposabljanjem kodirnik in dekoder optimizirata parametre za zmanjšanje napake pri rekonstrukciji in hkrati posodobita pomnilniški modul za snemanje prototipnih elementov kodiranih normalnih podatkov. Glede na testni vzorec model za izvedbo rekonstrukcije uporablja le omejene normalne vzorce, posnete v pomnilniškem modulu. Na ta način je rekonstrukcija blizu normalnemu vzorcu. Zato je napaka rekonstrukcije normalnega vzorca majhna, nenormalna napaka pa velika.
Slika 1: (diagram poteka predlaganega pomnilnika AE.

2.1. Kodirniki in dekoderji. (e kodirnik in dekoder sta dva dela AE. (e prvi preslika vhodne podatke v prostor funkcij, da dobi njihovo kodirano vrednost, drugi pa rekonstruira kodirano vrednost v vhodne podatke. (e AE je sestavljen iz kodirnik fw1 (·) in dekoder gw2 (·), ki se lahko izrazita kot

kjer sta x in x' vhod AE oziroma rekonstruirani vhod, z so rezultati kodiranja x, W1 in W2 pa označujeta parametre kodirnika in dekoderja, ki ju je mogoče dobiti z zmanjšanjem napake rekonstrukcije med x in x′:

Z rekonstrukcijo napake običajnega vzorca [19, 20], da bi ugotovili, ali je nenormalen, je bil AE uspešno uporabljen za reševanje naloge odkrivanja nenormalnosti. Vendar mora biti rekonstrukcija nenormalnih vzorcev nepredvidljiva, kar lahko povzroči večje napake pri rekonstrukciji nenormalnih vzorcev. Da bi rešili to težavo, je v razdelku 2.2 AE predstavljen pomnilniški modul in predlagan je pomnilniški AE.
2.2. Pomnilniški modul. (Predlagana metoda vključuje pomnilniški modul za snemanje načina kodiranja prototipa in operacijo naslavljanja za dostop do pomnilniškega modula.
2.2.1. Predstavitev, ki temelji na pozornosti. (E pozornostni modul je zasnovan kot matrika M ∈ RN×C, ki vsebuje N vektorjev v realnem času. Zaradi preprostosti predpostavimo, da je C dimenzija z; nato naj bo Ζ � RC. Podan je vrstični vektor mi, ∀i ∈ [ N], kjer je [N] celo število od 1 do N. Vsak predstavlja mi pomnilniški element; glede na nabor poizvedb z ∈ RC pomnilniško omrežje pridobi?z in odgovori z vektorjem mehkega naslova w ∈ R1×N kot sledi:

kjer je w vektor vrstice in je vsota vseh postavk 1, kar predstavlja wi, postavko w od i. (e vektor teže w je mogoče dobiti z izračunom z. Kot je prikazano v enačbi (4), mora biti utež naslova blizu w pomnilniškega modula. (e mešani parameter je definiran kot N, največja zmogljivost pomnilniškega modula. Čeprav je N, ni enostavno najti najboljšega za različne nabore podatkov; na srečo AE pomnilnika ni občutljiv na nastavitev N. V zadostni meri je mogoče velik N dobro uporabiti za vsak nabor podatkov.
2.2.2. Pozor za pomnilniško naslavljanje. V Memory AE je pomnilniški modul zasnovan tako, da podrobno beleži prvotni običajni način M faze usposabljanja. (e pomnilniški modul je definiran kot vsebinsko naslovljiv pomnilnik, z⌢, in njegova shema naslavljanja izračuna w, utež pozornosti, na podlagi podobnosti med poizvedbo in pomnilniškim elementom. Kot je prikazano na sliki 1, je mogoče vsako utež izračunati prek delovanje softmax wi :

kjer d(·, ·) predstavlja mero podobnosti. (papir ga definira kot podobnost kosinusa:

Tako kot enačbe (4)–(6) pomnilniški modul pridobi najbolj podoben pomnilniški element, da dobi predstavitev z. Zaradi omejitve velikosti pomnilnika in tehnologije redkega naslavljanja je mogoče naenkrat nasloviti le majhno število elementov notranjega pomnilnika. (zato je učinkovito obnašanje pomnilniškega modula mogoče razložiti na naslednji način. V fazi usposabljanja je dekoder v pomnilniku AE omejen na uporabo zelo malo naslovljivih pomnilniških elementov za rekonstrukcijo, kar zahteva učinkovito uporabo pomnilniških elementov. (zato , med rekonstrukcijo je treba pomnilniški modul prisiliti, da posname najbolj reprezentativen način prototipa v normalnem vhodnem načinu. V testni fazi je glede na naučeni pomnilnik mogoče za rekonstrukcijo pridobiti samo običajni način v pomnilniku. (torej normalne vzorce je mogoče bolje rekonstruirati.Nasprotno pa je mogoče kodirano vrednost nenormalnega vnosa nadomestiti s pridobljenim normalnim vzorcem, kar povzroči veliko napako rekonstrukcije v nenormalnem vzorcu.
2.3. Usposabljanje. Glede na nabor podatkov, ki vsebuje vzorce xi? ?TI�1, naj xi′ označuje rekonstrukcijske vzorce xi v učnih vzorcih; minimalno refaktoriranje se izvede na naslednji način:

(Norma e l2 se uporablja za merjenje napake rekonstrukcije; wi′ predstavlja težo naslavljanja pomnilnika vsakega vzorca xi. Da bi dodatno spodbujali redkost w′, je med treningom redka regulacija minimizirana. Ob upoštevanju, da so vsi w′ nenegativni in ‖w′‖1 � 1 se optimizacijski problem oblikuje na naslednji način:

S kombinacijo funkcije izgube enačbe (7) in enačbe (8) je ciljna funkcija AE spomina naslednja:

tukaj je hiperparameter v procesu usposabljanja. V praksi je nastavljen na 0.0002. V procesu usposabljanja se spomin posodablja s širjenjem nazaj in gradientnim spuščanjem. Pri povratnem širjenju je lahko različen od nič le gradient pomnilniške postavke z utežjo naslavljanja, ki ni nič.
2.4. Test. Ko je model usposobljen, lahko napako rekonstrukcije piksla na položaju (x, y) zobnega okvirja t izračunamo z naslednjo enačbo:

kjer h(·) predstavlja celoten model. Glede na napako rekonstrukcije na ravni slikovnih pik desetega okvirja lahko napako rekonstrukcije celotnega okvirja slike dobimo s seštevanjem e(t) �. (x,y)e(x, y, t). (en, oceno anomalije okvirja je mogoče izračunati na naslednji način:

Končno se lahko nastavi prag, da se ugotovi, ali je nenormalen, ko je s(t) > θ.
3. Eksperimentirajte
V tem razdelku je učinkovitost predlagane metode preverjena in primerjana z drugimi obstoječimi metodami. Trenutno se za poskuse uporabljata dva javna nabora podatkov, nabor podatkov Avenue in nabor podatkov ShanghaiTech. (e okvirna površina pod krivuljo (AUC) in EER se uporabljata kot indikatorja kvantitativnega vrednotenja.
3.1. Priprava. (Podatkovni niz e Avenue uporablja fiksno kamero z ločljivostjo 640 × 360 slikovnih pik za zajemanje in snemanje uličnih dejavnosti mestne univerze v Hongkongu. (e-podatkovni niz Computational Intelligence and Neuroscience 3 vključuje 16 video posnetkov usposabljanja, ki vsebujejo običajno človeško vedenje in 21 testni videoposnetki, ki vsebujejo nenormalne dogodke in človeško vedenje. Ima skupno 30652 sličic in vsi testni videoposnetki imajo opombe na ciljni ravni, kar pomeni, da se za označevanje anomalij na prostorskih lokacijah uporablja pravokotno območje. Normalno vedenje je, da ljudje hodijo po pločnik, medtem ko so neobičajni dogodki ljudje, ki smetijo/odvržejo predmete, tavajo, hodijo proti kameri, hodijo po travi in odvržejo predmete. (Nabor podatkov e ShanghaiTech je zelo zahtevna zbirka za odkrivanje nenavadnih dogodkov. Za razliko od drugih naborov podatkov vsebuje 13 različnih prizore z različnimi svetlobnimi pogoji in koti kamere, vključno s skupno 330 vadbenimi videoposnetki in 107 testnimi videoposnetki. (E testni niz vsebuje skupno 130 nenormalnih dogodkov z opombami na ravni slikovnih pik. (Celoten nabor podatkov ima skupno 316154 sličic, vključno z 274515 sličicami v nizu za usposabljanje, 42883 sličicami v testnem nizu in 17090 sličicami v neobičajnem okvirju. (Ločljivost vsakega video okvirja je 480 × 856. (Model je testirano na platformi s strojno platformo NVIDIA GTX1080TI in 8 GB video pomnilnika, programsko okolje pa je PyTorch in Python 3.6.Za merjenje učinkovitosti metode za odkrivanje video anomalij, predlagane v tem dokumentu, je AUC na ravni okvirja kot indeks ocenjevanja se uporablja krivulja delovanja sprejemnika (ROC). Za kazalnike ocenjevanja na ravni okvirja, če je vsaj ena slikovna pika okvirja označena kot nenormalna, se okvir šteje za nenormalnega. AUC na ravni okvirja pa se izračuna s primerjavo rezultat zaznavanja na ravni okvirja z ravnijo okvirja prave oznake.
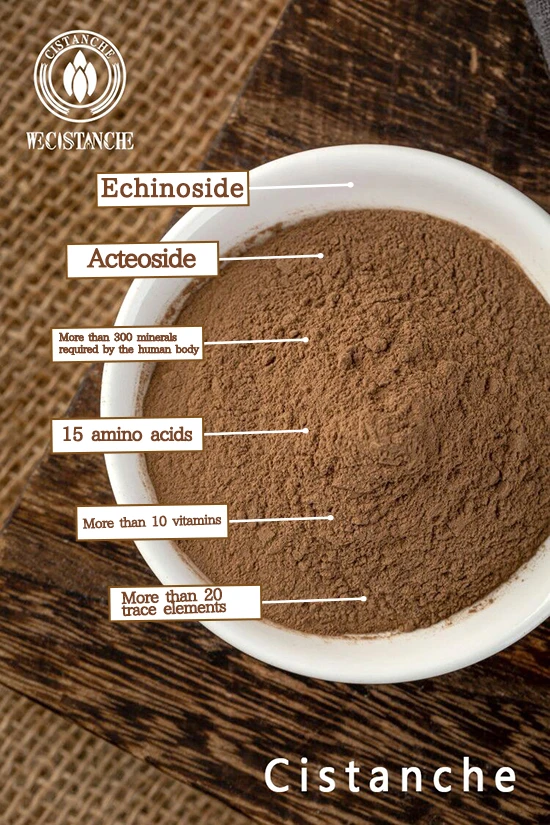
Glavne kemične sestavine Cistanche deserticola
Kliknite tukaj za ogled izdelkov Cistanche
【Vprašajte za več】 E-pošta:cindy.xue@wecistanche.com/Whats App: 0086 18599088692/Wechat: 18599088692
3.2. Eksperimentalna postavitev. Vsi video okvirji so prilagojeni na 227 × 227 in nato pretvorjeni v slike v sivinah. (e vhod modela je 227 × 227 × 5, kar pomeni, da se kot vhod modela uporablja 5 zaporednih sličic. Za vsako konvolucijsko plastjo je paketna normalizacijska plast in vzbujevalna plast ReLU. (e dekoder vključuje 4 dekonvolucijske plasti. (E pozornostni modul je nastavljen tako, da vsakemu pomnilniškemu segmentu omogoči, da posname funkcijo na slikovni piki na zemljevidu funkcij, ki ustreza podregiji video segmenta. (zato je pomnilniški modul 10 00 × 64 matrika. (e Adamov optimizator je izbran za optimizacijo celotnih parametrov modela. (e začetna stopnja učenja je 0,0001 in število iteracij je 1000. (e parameter momenta je ρ1 � 0,9 in ρ2 � 0,999, velikost serije pa je 128.
3.3. Eksperimentalni rezultati. Da bi dokazali učinkovitost predlagane metode pri odkrivanju video anomalij, jo ta članek primerja z 12 različnimi obstoječimi metodami. Med njimi sta MPPCA (hibrid verjetnostnega analizatorja glavnih komponent) plus SF (družbena moč) [17] in MDT (hibrid dinamične teksture) [18] metode, ki temeljijo na ročnih funkcijah; Conv-AE [8], 3D Conv [19], Stacked RNN [20] in ConvLSTM-AE [21], MemNormality [10] in ClusterAE [22] so vse metode, ki temeljijo na samodejnih kodirnikih; AbnormalGAN [7] in Pred plus Recon [23] temeljita na metodi generiranja kontradiktornih omrežij. Tabela 1 prikazuje rezultate zaznavanja video anomalij na ravni okvirja z različnimi metodami. Opaziti je mogoče, da je pri rezultatih obeh naborov podatkov metoda, ki temelji na AE, običajno boljša od metode, ki temelji na ročno izdelanih značilnostih, in dobijo se višje AUC na ravni okvirja. (ker se ročno izdelane funkcije običajno ekstrahirajo na podlagi drugih nalog in so zato morda neoptimalne. Pri metodah, ki temeljijo na AE, je ConvLSTM-AE boljši od Conv-AE, ker lahko prvi bolje zajame informacije o času. Poleg tega lahko tudi Upoštevati je treba, da metode, ki temeljijo na GAN, delujejo bolje kot večina osnovnih metod. Končno, metoda Memory AE, predlagana v tem dokumentu, doseže 85,7 odstotka AUC na ravni okvirja na naboru podatkov Avenue, kar je 0,6 odstotka pred najuspešnejšim Pred plus Recon [23]; medtem ko je metoda, predlagana v tem dokumentu, dosegla 75,3 odstotka AUC na ravni okvirja na naboru podatkov ShanghaiTech, kar je 2 odstotka pred drugimi metodami v AUC na ravni okvirja, učinek pa je zelo očiten. (predvsem zato, ker predlagana metoda, ki temelji na AE pomnilnika, uporablja fragmente pomnilnika, ki lahko dobro rekonstruirajo anomalije in povzročijo nekatere naključne napake. Poleg tega je v primerjavi z naborom podatkov Avenue nabor podatkov ShanghaiTech dosegel višjo AUC na ravni okvirja (predvsem zato, ker nabor podatkov ShanghaiTech vsebuje več prizorov in nenormalnih dogodkov, ki se prej niso pojavili v drugih nizih podatkov, kar je bolj zapleteno. Da bi preverili rezultate zaznavanja posameznega prizora v naboru podatkov ShanghaiTech, se za usposabljanje in testiranje uporablja video segment enega prizora. 83 segmentov (25 odstotkov) se uporablja za usposabljanje in 34 segmentov (32 odstotkov) se uporablja za testiranje, pri čemer se doseže 86.3-odstotna AUC na ravni okvirja, ki je dosegel raven, podobno tisti v naboru podatkov Avenue. Če povzamemo, predlagano metodo Memory AE je mogoče prilagodljivo uporabiti za različne vrste podatkov. Le z uporabo rekonstrukcijskih napak lahko predlagana metoda doseže boljše rezultate z najmanj specifičnim znanjem. Da bi ocenili zmogljivost vnaprej določenega pomnilniškega modula pri zaznavanju nenormalnih video dogodkov, je naslednji korak sprememba velikosti pomnilniškega modula in izvajanje poskusov na naboru podatkov Avenue, vrednosti AUC na ravni okvirja pa so podane v tabeli 2. je mogoče ugotoviti, da lahko pri dovolj veliki velikosti pomnilniškega modula metoda Memory AE robustno zagotovi najboljše rezultate. Ko je velikost pomnilniškega modula večja od 1000, je vpliv na rezultat zaznavanja majhen, vendar bo uporaba večje velikosti pomnilniškega modula povzročila večjo količino izračuna, zato je velikost pomnilniškega modula izbrana kot 1000. Slike 2(a) oziroma 2(b) prikazujeta nekaj rezultatov zaznavanja v naboru podatkov Avenue in naboru podatkov ShanghaiTech. (e Tabela 1: Primerjava z najsodobnejšimi metodami glede AUC.

boljša od metode, ki temelji na ročno izdelanih funkcijah, in dosežene so višje AUC na ravni okvirja. (ker se ročno izdelane funkcije običajno ekstrahirajo na podlagi drugih nalog in so zato morda neoptimalne. Pri metodah, ki temeljijo na AE, je ConvLSTM-AE boljši od Conv-AE, ker lahko prvi bolje zajame informacije o času. Poleg tega lahko tudi Upoštevajte, da metode, ki temeljijo na GAN, delujejo bolje kot večina osnovnih metod. Nazadnje, metoda Memory AE, predlagana v tem dokumentu, doseže 85,7 odstotka AUC na ravni okvirja na naboru podatkov Avenue, kar je 0.6 odstotkov pred najbolj zmogljiva metoda Pred plus Recon [23]; medtem ko je metoda, predlagana v tem dokumentu, dosegla 75,3 odstotka AUC na ravni okvirja na naboru podatkov ShanghaiTech, kar je 2 odstotka pred drugimi metodami na ravni AUC na ravni okvirja, učinek pa je zelo očiten. .(predvsem zato, ker predlagana metoda, ki temelji na Memory AE, uporablja fragmente pomnilnika, ki lahko dobro rekonstruirajo anomalije in uvedejo nekatere naključne napake. Poleg tega je nabor podatkov ShanghaiTech v primerjavi z naborom podatkov Avenue dosegel višjo AUC na ravni okvirja. (je predvsem zato, ker nabor podatkov ShanghaiTech vsebuje več prizorov in nenormalnih dogodkov, ki se prej niso pojavili v drugih naborih podatkov, kar je bolj zapleteno. Da bi preverili rezultate zaznavanja posameznega prizora v naboru podatkov ShanghaiTech, se za usposabljanje in testiranje uporablja video segment enega prizora. 83 segmentov (25 odstotkov) se uporablja za usposabljanje in 34 segmentov (32 odstotkov) se uporablja za testiranje, pri čemer se doseže 86.3-odstotna AUC na ravni okvirja, ki je dosegel raven, podobno tisti v naboru podatkov Avenue. Če povzamemo, predlagano metodo Memory AE je mogoče fleksibilno uporabiti za različne vrste podatkov. Le z uporabo rekonstrukcijskih napak lahko predlagana metoda doseže boljše rezultate z najmanj specifičnim znanjem. Da bi ocenili zmogljivost vnaprej določenega pomnilniškega modula pri zaznavanju nenormalnih video dogodkov, je naslednji korak sprememba velikosti pomnilniškega modula in izvajanje poskusov na naboru podatkov Avenue, vrednosti AUC na ravni okvirja pa so podane v tabeli 2. je mogoče ugotoviti, da lahko pri dovolj veliki velikosti pomnilniškega modula metoda Memory AE robustno zagotovi najboljše rezultate. Ko je velikost pomnilniškega modula večja od 1000, je vpliv na rezultat zaznavanja majhen, vendar bo uporaba večje velikosti pomnilniškega modula povzročila večjo količino izračuna, zato je velikost pomnilniškega modula izbrana kot 1000. Slike 2(a) oziroma 2(b) prikazujeta nekaj rezultatov zaznavanja v naboru podatkov Avenue in naboru podatkov ShanghaiTech. (okvirji v zelenem polju so običajni okvirji iz običajnih video posnetkov, okvirji v rdečem polju pa so neobičajni okvirji iz neobičajnih video posnetkov. Nekateri neobičajni dogodki, kot je padanje konfetov, vožnja s kolesom po pločniku, pretepi itd., lahko odkriti.
Tabela 2: (vpliv števila velikosti pomnilnika na eksperimentalne rezultate nabora podatkov Avenue (na ravni okvirja AUC/odstotek).

Slika 2: Primeri rezultatov detekcije. (a) Primer iz nabora podatkov Avenue. (b) Primer iz nabora podatkov ShanghaiTech.

4. Sklep
(prispevek predlaga Memory AE za izboljšanje učinkovitosti zaznavanja anomalij velikih podatkov v videoposnetkih. Glede na vhod predlagana metoda Memory AE najprej uporabi kodirnik za pridobitev kodirane predstavitve in nato uporabi kodo kot poizvedbo za pridobitev najbolj ustreznega vzorcev v pomnilniškem modulu za rekonstrukcijo Ker je pomnilniški modul usposobljen za snemanje tipičnih normalnih vzorcev, lahko predlagani pomnilniški AE dobro rekonstruira normalne vzorce in poveča napako rekonstrukcije nenormalnosti, kar krepi vlogo napake rekonstrukcije kot standarda za odkrivanje nenormalnosti. Eksperimenti na dveh naborih podatkov dokazujejo vsestranskost in učinkovitost predlagane metode. V prihodnosti bomo preučevali uporabo uteži naslavljanja za odkrivanje nepravilnosti. Glede na to, da je predlagani pomnilniški modul univerzalen in nima nobene zveze s strukturo kodirnika in dekoder, bo integriran v kompleksnejši osnovni model in uporabljen v poskusih na zahtevnejših nizih podatkov.
Cistanche dodatek blizu mene-izboljšanje spomina
Reference
[1] F. Dong, Y. Zhang in X. Nie, "Dvojno diskriminatorsko generativno kontradiktorno omrežje za odkrivanje video anomalij," IEEE Access, vol. 8, str. 88170–88176, 2020.
[2] K. Doshi in Y. Yilmaz, »Any-shot sequential anomaly detection in surveillance videos«, v Proceedings of the CVPRW, str. 934-935, Seattle, WA, ZDA, junij 2020.
[3] K. Doshi in Y. Yilmaz, »Nenehno učenje za odkrivanje anomalij v nadzornih videoposnetkih,« v zborniku CVPRW, str. 254-255, Seattle, WA, ZDA, junij 2020.
[4] K. Jayanta, "Dutta in bonny Banerjee. Spletno odkrivanje nenormalnih dogodkov z uporabo inkrementalne dolžine kodiranja," v Proceedings of the AAAI, str. 3755–3761, Austin, Teksas, ZDA, januar 2015.
[5] Y. Feng, Y. Yuan in X. Lu, "Učenje globokih modelov dogodkov za odkrivanje anomalij v množici", Neurocomputing, vol. 219, str. 548–556, 2017.
[6] D. Gong, L. Liu, V. Le et al., "Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection," v Proceedings of the ICCV, str. 1705–1714, Seul, Koreja, oktober 2019.
[7] M. Ravanbakhsh, M. Nabi, E. Sangineto, L. Marcenaro, C. Regazzoni in N. Sebe, »Zaznavanje nenormalnih dogodkov v videoposnetkih z uporabo generativnih kontradiktornih mrež,« v Proceedings of the IEEE International Conference on Image Processing , str. 1577–1581, Peking, Kitajska, september 2017.
[8] M. Hasan, J. Choi, J. Neumann, AK Roy-Chowdhury in LS Davis, "Učenje časovne pravilnosti v video sekvencah," v zborniku IEEE konference o računalniškem vidu in prepoznavanju vzorcev, str. 733– 742, Las Vegas, NV, ZDA, junij 2016.
[9] W. Liu, W. Luo, D. Lian in S. Gao, "Future frame prediction for anomaly detection–a new baseline," v Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, str. 6536– 6545, Salt Lake City, UT, ZDA, junij 2018.
[10] H. Park, J. Noh in B. Ham, "Learning-Memory-guided normality for anomaly detection," v Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, str. 14 372–{{ 3}}, Seattle, WA, ZDA, junij 2020.
[11] MZ Zaheer, J.-h. Lee, M. Astrid in S.-I. Lee, "Old is gold: redefining the adversarially learned one-class classifier training paradigm," v Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, str. 14 183–214 193, Seattle, WA, ZDA, junij 2020.
[12] X. Zhu, J. Liu, J. Wang, Y. Fang in H. Lu, "Odkrivanje anomalij v prenatrpanem prizorišču prek skupnega modeliranja videza in dinamike," v Zborniku mednarodnih konferenc IEEE o obdelavi slik, str. 2705–2708, Melbourne, VIC, Avstralija, september 2013.
[13] RVHM Colque, CAC J´unior in WR Schwartz, "Histogrami orientacije optičnega kolega in magnitude za odkrivanje nenavadnih dogodkov v videoposnetkih," v Zborniku konference Sibgrapi o grafiki, vzorcih in slikah, str. 126–133. , Salvador, Bahia, Brazilija, avgust 2015.
[14] Bo Zong, S. Qi, RM Martin et al., »Model Gaussove mešanice z globokim samokodiranjem za nenadzorovano odkrivanje anomalij,« v Zborniku mednarodnih konferenc o predstavitvah učenja, Vancouver, Kanada, april 2018.
[15] M. Sabokrou, M. Fayyaz, M. Fathy, Z. Moayed in R. Klette, "Globoka anomalija: popolnoma konvolucijska nevronska mreža za hitro odkrivanje anomalij v natrpanih prizorih," Computer Vision and Image Understanding, vol. 172, str. 88–97, 2018.
[16] C. Li, Z. Han, Q. Ye in J. Jiao, "Vizualno zaznavanje nenormalnega vedenja na podlagi analize redke rekonstrukcije trajektorije," Neurocomputing, vol. 119, št. 7, str. 94–100, 2013.
[17] V. Mahadevan, W. Li, V. Bhalodia in N. Vasconcelos, "Zaznavanje anomalij v natrpanih prizorih," v zborniku IEEE konference o računalniškem vidu in prepoznavanju vzorcev (CVPR), str. 1975–1981, IEEE, San Francisco, CA, ZDA, junij 2010.
[18] W. Li, V. Mahadevan in N. Vasconcelos, "Odkrivanje in lokalizacija anomalij v natrpanih prizorih," IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 36, str. 18–32, 2014.
[19] Y. Zhao, B. Deng, C. Shen, Y. Liu, H. Lu in X.-S. Hua, »Spatio-Temporal AutoEncoder for video anomaly detection«, v zborniku mednarodne konference ACM o multimediji (ACM MM), str. 1933–1941, ACM, Mountain View California ZDA, oktober 2017.
[20] W. Luo, L. Wen in S. Gao, "Ponovni pregled odkrivanja anomalij na podlagi redkega kodiranja v ogrodju zloženega RNN," v zborniku Mednarodne konference IEEE o računalniškem vidu (ICCV), Benetke, Italija, oktober 2017.
[21] W. Luo, L. Wen in S. Gao, "Spominjanje zgodovine s konvolucijskim LSTM za odkrivanje anomalij," v zborniku IEEE International Conference on Multimedia and Expo (ICME), str. 439–444, IEEE, Hong Kong, julij 2017.
[22] Y. Chang, Z. Tu, W. Xie in J. Yuan, "Clustering driven deep autoencoder for video anomaly detection," v Proceedings of the European Conference on Computer Vision (ECCV), str. 329–345, Springer, Glasgow, Združeno kraljestvo, avgust 2020.
[23] L. Wen, W. Luo, D. Lian in S. Gao, "Future frame prediction for anomaly detection – a new baseline," v Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), str. 6536–6545, IEEE, Salt Lake City, UT, ZDA, junij 2018.
[24] M. Song, "Poprečni terenski pogled na pokrajino dvoslojnih nevronskih mrež," Proceedings of the National Academy of Sciences, vol. 115, št. 33, str. E7665–E7671, 2018.
[25] B. Ding in G. Wen, "Omejitev redkosti najbližjega podprostorskega klasifikatorja za prepoznavanje ciljev slik SAR," Journal of Visual Communication and Image Representation, vol. 52, str. 170–176, 2018.
[26] T. Wang in H. Snoussi, "Odkrivanje nenormalnih vizualnih dogodkov prek globalnega optičnega orientacijskega histograma," IEEE Transactions on Information Forensics and Security, vol. 9, št. 6, str. 988–998, 2014.